
生成AIを利用する際、特に業務利用の場合は、入力した情報を外部のクラウドサービスへ送信することに不安を感じる方も少なくありません。サービスによっては学習への利用をオプトアウトできるほか、法人向けにデータ保持を制限する仕組みなども用意されています。一方、AI処理そのものを自社環境内で完結させたいという方にとって、有力な選択肢となるのが「ローカルLLM」です。
ローカルLLMでは、AI処理を自身のパソコン、あるいは自社サーバーで行えます。かつてのローカルLLMは、専用の高額なサーバーを必要とするケースも多くありました。しかし、現在では高性能なデスクトップPCでも運用可能となり、導入のハードルは大きく下がっています。
そこで今回は、ローカルLLMの仕組みから、運用するために必要なAIモデルやソフトウェア、さらには必要となるパソコンのスペックなどを解説しますので、ぜひ参考にしてみてください。
目次
1.ローカルLLMとは?
「ローカルLLM」は、大規模言語モデル(LLM:Large Language Model)を自身のパソコンや社内サーバーなどで動かす利用形態のことです。ChatGPTやClaudeのように事業者側のサーバーへアクセスするわけではありません。モデルデータを自身の環境に用意し、文章生成などの処理に利用する点が大きな特徴です。
以前は導入のハードルが非常に高いものでした。しかし、最近ではOllamaやLM Studioなどのソフトウェアが登場したことにより、ローカルLLMの環境が構築しやすくなっています。さらに、モデルについても小型から大型まで幅広い選択肢があり、パソコンやサーバーの性能、用途にあわせた選択が可能です。LM Studioの場合、ダウンロード済みのモデルをオフラインで利用できるため、チャットやローカル文書の参照なども端末内で処理できます。
1-1.「ローカルLLM」とは自分のパソコンや社内環境で動かすAI
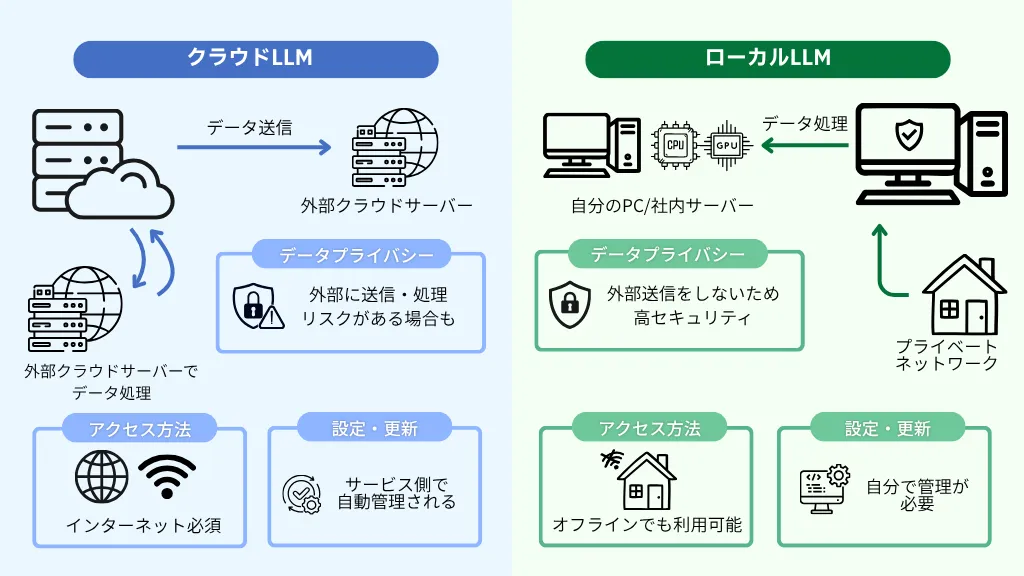
クラウド型の生成AIは、ユーザーが入力した内容をサービス提供者の環境に送信し、サービス提供者側の環境でAIが処理します。一方、ローカルLLMではAIモデルを自身のパソコンや社内サーバーに保存し、自身の環境内でAI処理します。
AIモデルをあらかじめダウンロードしておくことで、インターネットに接続することなく生成AIを利用できる環境も構築できます。LM Studioでは、ダウンロード済みのAIモデルとのチャットや文書参照、ローカルAPIサーバーの利用がオフラインで行えます。そのため、外部ネットワークへの接続を制限した環境でもAIを利用できる点が大きな特徴です。
1-2.ChatGPTやClaudeなどの生成AIとの違いは?
ChatGPTやClaudeなどのクラウド型生成AIは、サービス提供者が用意した高性能な計算環境を利用できる点が大きな強みです。ユーザー側は高性能なパソコンを用意する必要がなく、アカウントを作成するだけの手軽さで生成AIを利用できます。AIモデルの更新やサーバー管理などもサービス提供者側によって行われるため、サービス利用者の管理負担が少ないのもメリットです。
一方、ローカルLLMの場合、使用するAIモデルやパソコン、データの保存場所、ネットワーク環境などを利用者側で選べます。社外へ送信したくないデータを扱いやすい点もメリットです。ただし、AIモデルの導入や更新、ハードウェア管理などは自分たちの手で行う必要があります。
また、クラウド型生成AIは大規模な計算資源を活用できるため、高性能な最新モデルを利用しやすい環境にあります。これに対し、ローカルLLMではパソコンに搭載されているメモリ容量やビデオカードのVRAMによって、利用できるAIモデルが制限されます。そのため、回答精度だけでなく、実行速度や必要スペックを考慮したAIモデル選びが重要です。
1-3.デスクトップ版AIとローカルLLMは別物
ChatGPTやClaudeには、パソコンにインストールして使うアプリ版が用意されています。ただし、この場合のアプリはあくまでもインターフェースを提供するもので、基本的なAI処理はインターネット上のサーバーで実行されています。
単なるデスクトップアプリなのか、ローカルLLMなのかを判断する基準は、アプリがインストールされている場所ではなく、AI処理が実行されている場所です。パソコンに保存したAIモデルを、そのパソコン上で動かしているのであればローカルLLMです。一方、実際の処理がサービス提供者側で実行されているのであればクラウド型となります。
2.ローカルLLMが注目される理由
生成AIを業務へ取り入れる場合、入力データの扱いや利用料金、外部サービスへの依存など、さまざまな課題を検討する必要があります。こうした課題に対する選択肢のひとつが、AIモデルを自社管理の環境で動作させるローカルLLMです。
ローカルLLMは、すべての用途においてクラウド型生成AIより優れているわけではありません。しかし、データ管理や利用量の自由度、自社向けのカスタマイズを優先したい場合には大きなメリットがあります。
2-1.社内データを外部に送信せずに使える
ローカルLLMを自身のパソコンや社内ネットワーク内だけで利用する場合、プロンプトや参照文書を外部のAIサービスに送信することなく処理できます。顧客情報、社内文書、未公開の開発資料など、取り扱いに注意が必要なデータをAIで扱いたい場合には大きなメリットとなります。
ローカルLLM用のソフトウェアでも、ダウンロード済みのAIモデルだけを使用し、外部サービスや外部ツールと連携しない構成であれば、チャットや文書参照などの処理をパソコン内で完結できます。
ただし、ローカルで動作するからといって、必ずしも安全とは言い切れません。モデルやソフトウェアをオンラインでダウンロード・更新する際には、インターネットへの接続が必要です。さらに、Web検索や外部API、MCPなどの外部ツールと連携すれば、外部通信が発生します。また、社内の誰がどのように使うか、利用履歴はどこに保存されるか、ネットワーク上から誰がアクセスできるかなど、セキュリティ面を考慮した設計も別途検討する必要があります。
2-2.自社専用のAI環境を作りやすい
ローカルLLMでは、使用するAIモデルやシステムプロンプト、参照させる文書などを自社側で選択できます。社内マニュアルだけを参照する質問回答AIや、開発部門向けのコーディング支援など、用途を限定したAIへの応用も可能です。
法人であれば、社内資料を検索して回答に反映させたり、既存の社内システムからAIを呼び出したりすることもできます。汎用のチャットツールとして使うだけでなく、扱うデータや業務の内容に合わせてAIの利用範囲を調整できる点がローカルLLMの強みです。
2-3.月額課金や利用制限に左右されにくい
クラウド型の生成AIは、月額料金やAPIの利用量に応じた料金が発生する場合があります。一方、ローカルLLMのオープンウェイトモデルを自前のパソコン上で動かす場合、推論するたびに外部APIの従量課金が発生することはありません。
たとえばOpenAIの「gpt-oss」は、AIモデル自体をダウンロードし、自分の環境で実行できるオープンウェイトモデルです。OpenAI APIやChatGPTから提供されるモデルではなく、利用者側が用意した環境で動かすAIモデルとして公開されています。
なお、ローカルLLMそのものに月額の利用料金は掛かりません。ただし、AI処理に使うパソコンの導入費用に加え、電気代やデータの保存、システムの保守などのランニングコストが発生します。利用状況によっては、クラウド型生成AIよりも総コストが高くなる可能性もあります。
3.ローカルLLMでできること
ローカルLLMの環境でも、文章作成、要約、翻訳、質問回答、コード生成など、一般的な生成AIと同様の用途に利用できます。また、AIモデルによっては画像や音声など、テキスト以外の入力に対応するものも増えています。
さらに、パソコン内のファイルや社内文書と組み合わせることによって、個人向けのAIアシスタントから法人向けの文書検索まで用途を広げることも可能です。
3-1.個人利用では文章作成・要約・翻訳・コーディングに使える
ローカルLLMを個人で利用する場合は、文章の下書きや要約、翻訳、アイデア整理などが主な用途です。メールの文案作成、長い資料の要点整理、プログラムコードの説明や修正候補の作成など、普段クラウド型生成AIで処理している作業の多くをローカル環境でも実行できます。
ローカルLLMは、外部へ送信したくない情報を扱いやすい点も大きなメリットです。一般公開前の原稿や個人的なメモ、開発中のソースコードなどをローカル環境内で処理できます。
なお、AIモデルによって得意分野は異なります。文章生成に強いものやコーディング性能を重視したもの、推論性能に重点を置いたものなど、AIモデルごとに特色があるため、単にサイズが大きいといった理由だけで選ぶのではなく、目的に合ったAIモデルを選択することが重要です。
3-2.法人利用では社内文書検索やFAQチャットボットに使える
法人利用の場合は、社内規程や社内マニュアル、製品資料などを参照し、質問に応じて必要な情報を提示する用途が代表的です。問い合わせ対応や社内ヘルプデスク、技術文書の検索などへの応用も法人利用ならではの使い方と言えます。
こうした用途では、質問に関連する文書を検索し、その内容をLLMへ渡して回答させる「RAG」がよく用いられます。LLMへ社内情報のすべてを追加学習させることなく、既存文書を参照させながら回答を生成できます。
実際の業務利用では、回答精度だけでなく「どの文書を参照したのか」を確認できるようにしたり、部署ごとに閲覧可能な文書を分けたりする対策も重要です。LLM単体の性能にとどまらず、周辺環境までを含めた設計が求められます。
4.代表的なローカルLLMと動かし方

ローカルLLMを利用するためには、AIの頭脳にあたる「AIモデル」と、それを動かすためのエンジンとなる「ソフトウェア」が必要です。そこに実際の処理を行うパソコン(ハードウェア)を組み合わせることで、ローカルLLMが動作します。
AIモデルは研究機関や企業などから公開されており、自分の環境にあったものを選んで利用します。一方、ソフトウェアはダウンロードしたAIモデルをパソコン上で読み込み、実際に処理を行うためのシステムであり、対応モデルや機能、使い勝手などを考慮して選択します。
4-1.主要なオープンモデルと日本語対応の状況
AIモデルは、大量のデータを使った学習によって調整された「パラメータ(重み)」の集合です。モデルによって性能や得意分野が異なるため、どのAIモデルを利用するかが使い勝手を大きく左右します。
代表的なものとして、Alibaba Cloudの「Qwen」、Googleの「Gemma」、OpenAIの「gpt-oss」、Metaの「Llama」などがあります。これらはモデルの重み(ウェイト)が公開された「オープンウェイト」あるいは「オープンモデル」と呼ばれるモデルです。
日本語を扱えるモデルも多くありますが、日本語が公式サポート対象かどうかや、日本語での回答品質はモデルによって異なります。そのため、日本語を中心に利用する場合は、実際の用途に近い質問を使って事前に検証することが重要です。
- Alibaba Cloud「Qwen」
多言語処理を得意とするAIモデルで、日本語の受け答えにも対応しています。小型から大型までサイズの選択肢が豊富で、パソコンの性能に合わせて選びやすいのが特徴です。
Qwenシリーズは更新が活発で、2026年には「Qwen3.5」に加えて「Qwen3.8」なども公開されています。世代やモデルサイズによって必要なハードウェア性能が大きく異なるため、導入する際は具体的なモデル名まで確認しましょう。
- Google「Gemma」
Googleが開発するAIモデルで、小型モデルから大型モデルまで複数のサイズが用意されています。
「Gemma 4」ではテキストや画像に対応するほか、一部モデルでは音声入力にも対応しています。比較的小型のモデルも用意されているため、大型のビデオカードを搭載していないパソコンを含め、幅広い環境で検討しやすいAIモデルです。
- OpenAI「gpt-oss」
OpenAIが公開するオープンウェイトの推論モデルで、「gpt-oss-20b」と「gpt-oss-120b」が用意されています。
推論の深さを調整できるほか、ツール利用やコーディングなどにも対応しています。Apache 2.0ライセンスで公開されており、利用条件が比較的明確なことも特徴です。業務利用を見据える場合にも検討しやすいでしょう。
- Meta「Llama」
Metaが開発する大規模AIモデルで、利用実績が多く、関連する解説やツールも豊富です。
「Llama 4」ではテキストと画像を扱えます。ただし、公式サポート言語に日本語は含まれていません。日本語による入出力が可能な場合でも、精度やニュアンスなどについては事前に検証する必要があります。
また、独自のライセンス条件が設定されているため、業務で利用する場合は利用条件の確認も必要です。
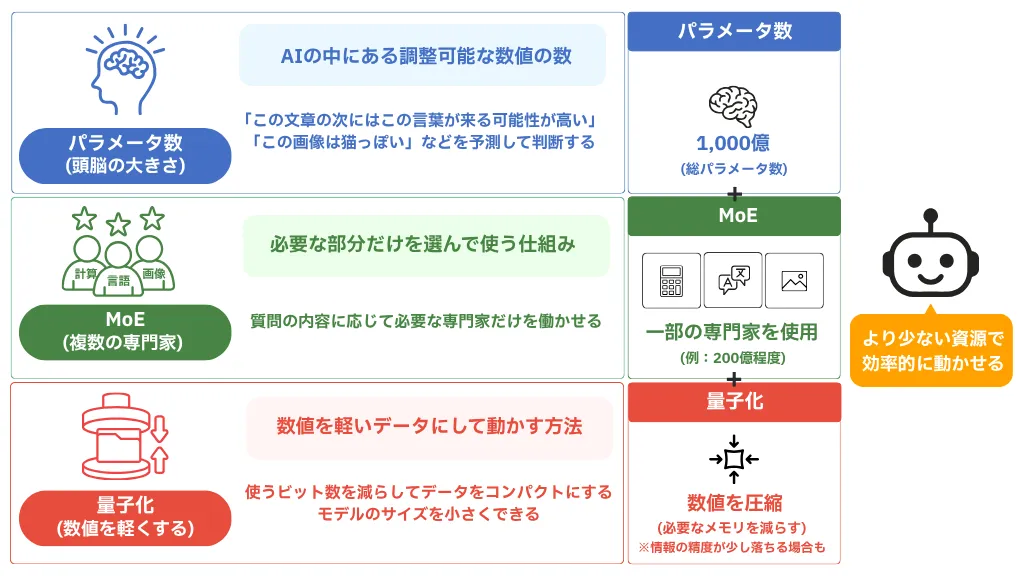
4-1-1.AIモデルの容量・必要スペックを左右する「パラメータ数」と「量子化」
AIモデルを選択する際、パソコンへの負荷を判断するうえで注目したいのが「パラメータ数」と「量子化」です。
「パラメータ数」は、「4B」「14B」などと表記されます。「B」は10億(Billion)を表す単位で、4Bなら40億、14Bなら140億です。一般的にパラメータ数が多いモデルほど高い能力を備える傾向があります。
とはいえ、AIモデルの性能はパラメータ数だけで決まるものではありません。モデルの設計や学習方法、学習データ、後学習などによっても性能は大きく異なります。
また、「MoE(Mixture of Experts)」と呼ばれる構造では、モデル全体のパラメータ数と、実際の推論時に使用する「アクティブパラメータ数」が異なる場合があります。そのため、単純にパラメータ数だけを比較して性能や必要スペックを判断できません。
もう一方の「量子化」は、モデルの重みをより少ないビット数で表現することで、ファイル容量や必要メモリを削減する技術です。GGUF形式の量子化モデルでは「Q8」「Q4」などの表記がよく使われます。一般に数字が小さいほど必要なメモリ容量を抑えやすくなります。
ただし、量子化の度合いが高くなるほど回答品質が低下する可能性があります。ローカルLLMでは、容量と回答品質のバランスから4bit前後の量子化モデルが多く利用されています。
4-1-2.AIモデルを日本語で利用する際の注意点
海外で開発されたAIモデルは、英語のほうが得意な場合があります。同じAIモデルでも、英語と日本語のどちらで質問するかによって、回答の質に差が出ることがあります。
また、小型モデルでは日本語の文章が不自然になったり、専門用語の扱いが不安定になったりする場合もあります。そのため、AIモデルを選択する際は、英語圏での評価だけを基準にせず、実際に利用する日本語の質問や文章を使って確認してから判断しましょう。
| 【AIモデル別の特徴】 | ||||
|---|---|---|---|---|
| モデル | 主な特徴 | 主なサイズ(パラメータ数)※Qwen3.5の例 | 日本語対応 | 向いている用途 |
| Qwen | 推論、コーディング、多言語処理などを幅広くこなします。小型から大型まで選択肢が多く、パソコンの性能に合わせて選びやすいのが特徴です | 0.8B、2B、4B、9B、27B、35B-A3B(MoE)など(Qwen3.5)。世代によって異なる | 多言語対応。日本語の会話・生成にも利用できますが、モデルやサイズによって精度に差があるため用途ごとの検証が前提となります | 文章作成、要約、翻訳、コーディングなど幅広い用途 |
| Gemma | Googleが開発するAIモデル。Gemma 4ではテキストや画像に対応し、E2B・E4B・12Bは音声入力にも対応します | E2B、E4B、12B、26B A4B、31Bなど | 35以上の言語を標準サポート。140以上の言語で事前学習 | 文章生成、要約、質問回答、画像の内容理解など |
| gpt-oss | OpenAIが公開する推論重視のモデル。推論の深さを調整でき、ツール利用やコーディングにも対応します | 20B、120B | 日本語でも利用可能ですが、日本語性能を重視する場合は実際の用途での検証が必要 | 複雑な推論、コーディング、ツール連携 |
| Llama | Metaが開発する大規模モデル。Llama 4ではテキストと画像を扱うことが可能で、長いコンテキストにも対応します | Scout:17B active/109B total、Maverick:17B active/400B totalなど | 日本語による入出力は可能な場合がありますが、Llama 4の公式サポート言語には日本語が含まれていないため事前検証が必要 | 長文処理、画像理解、コーディングなど |
4-2.LM StudioやOllamaを使えばマウス操作も可能
使用するAIモデルが決まったら、次はそれを動かすためのソフトウェアを用意します。ローカルLLMというと、黒い画面にコマンドを打つ作業を想像する方も少なくありません。しかし、現在は通常のソフトウェアと同様に、マウス操作を中心に利用できる環境も増えています。
代表的なソフトウェアとして挙げられる「LM Studio」は、公式サイトからインストーラーをダウンロードし、一般的なアプリケーションと同じ手順でインストールします。 起動後はAIモデルをダウンロードすれば、チャット画面からそのまま利用可能です。別のAIモデルを利用したい場合は、ソフトウェア内の検索欄からAIモデル名を入力します。同じAIモデルでもパラメータ数や量子化レベルが異なるものが表示されるため、使用するパソコンのメモリ容量などに合わせて選択しましょう。
LM Studioには、モデルを読み込む際に必要なメモリ量を推定し、メモリ不足が予想される場合には警告を表示する機能も用意されています。モデルを読み込んだ後は、チャット欄に日本語で質問を入力するだけで、クラウド型生成AIに近い感覚で利用できます。
一方、「Ollama」はローカルLLMを簡単に実行できるソフトウェアです。APIを通じてほかのアプリケーションから呼び出す用途にも向いており、自作ツールや社内システムへの組み込みなどにも利用されています。OllamaにもGUI環境も用意されていますが、ローカルLLMを手軽に試してみたい場合は、モデルの検索や設定を画面上で操作しやすい「LM Studio」から始めるのがおすすめです。
5.ローカルLLMのデメリット・注意点
ここまで紹介してきたとおり、ローカルLLMにはデータ管理や利用量の自由度が高いなどのメリットがあります。その一方で、クラウド型生成AIではサービス提供者が担っている部分を利用者自身で管理しなければなりません。
特に法人利用では、AIモデルが動かせることと、安定して業務で利用できることは別の問題です。性能面はもちろん、技術面やライセンス、導入コスト、ランニングコストまでを含めた検討が必要です。
5-1.業務で使うには技術知識が必要
個人がパソコンでチャットを試すだけなら、LM StudioやOllamaを使えば比較的簡単にローカルLLMを導入できます。一方、複数人が業務で利用するとなると、ビデオドライバーやAIモデル管理、サーバー設定、ネットワーク、ユーザー認証などの知識が求められます。
社内文書を参照させる場合には、文書の登録や更新、検索精度、アクセス権限なども考慮する必要があります。また、APIとして社内ネットワークに公開する場合は、不特定の端末から接続できないように認証などの設定も欠かせません。
LM Studioにもローカルネットワークへの公開機能やAPIトークンによる認証設定などが用意されています。業務で利用する場合は、単にAIモデルを起動するだけでなく、ネットワークやアクセス権限まで含めた設計が重要です。
5-2.回答精度や処理速度はAIモデルとパソコン性能に左右される
ローカルLLMの回答精度は、使用するAIモデルによって大きく変わります。小型のAIモデルは少ないメモリ容量で動かせる反面、複雑な推論や長文の理解では、大型のAIモデルとの差が出やすくなります。
処理速度にはパソコンの性能も大きく影響します。特にGPUの性能とVRAM容量が重要です。AIモデルのデータをVRAM上により多く配置できるほど、高速な処理が期待できます。逆にVRAMに収まりきらない場合は、モデルの一部をシステムメモリへ配置して実行するため、処理速度が低下するおそれがあります。
同じAIモデルでも、長い文章を入力したり、複数のリクエストを同時に処理したりする場合は、必要となるメモリ容量が増加します。実際、Ollamaの公式FAQでも、並列処理数とコンテキスト長に応じてメモリ使用量が増えると説明されています。
5-3.商用利用ではAIモデルごとにライセンス条件が異なる
ローカルLLMとして使えるモデルでも、AIモデルによって利用条件は異なります。特に、商用利用や改変、再配布、自社サービスへの組み込みなどについては個別の条件が設定されている場合があるため、事前の確認が必要です。
たとえば、gpt-ossはApache 2.0ライセンスで公開されており、商用を含む幅広い用途での利用や改変、再配布が認められています。ただし、OpenAIが定めるgpt-ossの利用ポリシーもあわせて確認する必要があります。Qwenについても世代やモデルごとにライセンス情報が公開されています。一方、Llamaのように独自のライセンス条件を採用しているモデルもあります。
モデル名が同じシリーズであっても、世代や個別モデルによって条件が変わることも珍しくはありません。業務に導入する場合は、実際に使用するモデルのライセンスを必ず確認しましょう。
5-4.初期費用はクラウド型生成AIよりも高くなりやすい
クラウド型の生成AIは、利用するパソコンの性能が高くなくても基本的に問題なく、サービスの契約後すぐに使い始められます。
一方、ローカルLLMを快適に動かす場合、特に中~大型モデルではビデオカード(GPU)を搭載したパソコンが有利となり、特に大型のAIモデルを扱う場合は、VRAM容量の大きいビデオカードや大容量のメインメモリ、高速なストレージなどが求められるため、パソコンの価格も高くなりがちです。
ローカルLLMは、生成するたびにクラウドサービスの利用料金が掛からないため、一見するとクラウド型生成AIよりもお得に思えます。しかし、初期費用に加えて、電気代や管理・保守費用などのランニングコストも含めると、必ずしも割安とは言い切れません。ローカルLLMを導入する際は、利用人数や利用頻度、必要なAIモデルの性能などを踏まえたコスト計算が重要です。
6.ローカルLLMに必要なPCスペック
クラウド型生成AIであれば、一般的な事務作業向けのパソコンでも基本的に問題ありません。しかし、ローカルLLMを利用する場合は、重視すべきスペックが異なります。
CPU性能はもちろん、特にビデオカードの性能とVRAM容量が重要です。さらに、メインメモリやストレージの容量なども含めた総合的な性能が求められます。
6-1.快適に使うためにはビデオカードが重要
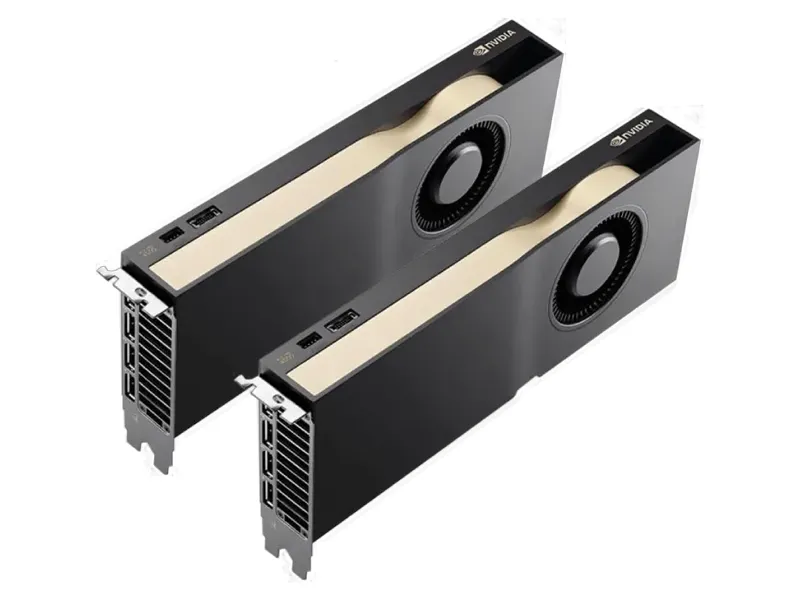
LLMの推論には大量の計算が伴うため、GPUを使うことで処理速度を高められます。CPUだけで動かせるAIモデルもありますが、文章を連続して生成するような用途では、並列処理能力の高いGPUを利用したほうがより快適です。
GPUの性能に加えてVRAMの容量も重要です。VRAMにはAIモデルのデータだけでなく、入力文や生成処理に使うデータなども格納されます。そのため、VRAM容量が大きいほど余裕を持ってAI処理を実行できます。
また、同時に複数のAIモデルを起動したり、長いコンテキストを扱ったりする場合は、必要となるVRAM容量も増加します。GPUだけで処理したい場合は、モデルデータや推論時に使う領域が、VRAMの空き容量に収まるかを確認しましょう。
6-2.VRAM容量別に動かせるモデルの目安
AIモデルが必要とするVRAM容量は、パラメータ数だけでなく量子化方式によっても変化します。量子化によってモデルデータが小さくなれば、同じAIモデルでも必要とするメモリ容量を抑えられます。そのため、ローカルLLMでは4bit量子化モデルを選ぶケースが一般的です。
たとえば「Gemma 4」の公式資料では、4bit量子化時の推論メモリの目安が、E4Bで約4.5GB、12Bで約6.7GB、26B A4Bで約14.4GB、31Bで約17.5GBとされています。
ただし、これはモデルの読み込みに必要な容量で、実際の推論ではコンテキストなどに使う領域が別途必要です。つまり、この数値と同じ容量のVRAMでは足りない場合もあります。
4bit量子化を前提に、GPU上で快適に扱いやすいモデルの目安としては、VRAMが8GBの場合は小型から8B前後、12~16GBの場合は8B~14B前後、24GB以上の場合は20B~30B級の量子化モデルなどが候補となります。もちろん、モデルの構造や量子化方式、コンテキスト長などによって必要容量は変わります。導入前には、実際に使用するモデルの要件を確認しておくと安心です。
6-3.メモリ・ストレージ・冷却性能も確認する
ローカルLLMを利用する場合、VRAMだけでなくメインメモリの容量も重要です。複数のソフトウェアを同時に使うときはもちろん、VRAMに収まりきらないモデルの一部を処理する際にも、メインメモリが使われます。 そのため、ローカルLLMを本格的に使用する場合は32GB以上、大型モデルや開発用途では64GB以上の搭載も検討したいところです。
AIモデルのファイル容量は数GBから数十GB以上に及びます。複数モデルを保存すれば合計で数百GBに達することもあるため、ストレージの空き容量にも余裕が必要です。可能であれば高速なNVMe SSDで1TB以上、用途によっては2TB以上を確保しておきましょう。
さらに、ローカルLLMを長時間、安定して稼働させるためには、PCケース内の冷却も欠かせません。 特にビデオカードは負荷が高くなりやすいため、エアフローなどもしっかり確保することが求められます。
| 【ローカルLLM運用に必要なスペック】 | |||||
|---|---|---|---|---|---|
| パーツ | 重要度 | 試用 | 個人用途 | 業務用途 | 本格運用 |
| GPU・VRAM | 最重要 | GPUなしでも可 | VRAM 8~12GB | VRAM 16GB以上 | VRAM 24GB以上 |
| メインメモリ | 重要 | 16GB以上 | 32GB以上 | 32~64GB | 64GB以上 |
| ストレージ | 中 | 空き50GB程度 | 空き200GB程度 | 空き500GB以上 | 空き1TB以上 |
| CPU | 中~高 | GPUなしなら性能が速度に直結 | ミドルレンジ以上 | ミドルレンジ以上 | ミドルレンジ以上 |
| 冷却性能 | 業務利用では重要 | 標準構成で可 | 標準構成で可 | 冷却を重視 | 冷却を重視 |
| モデルサイズの目安(4bit量子化時) | - | 1B~4B | 7B~8B前後(12GBなら14B前後) | 14B前後 | 20B~30B級 |
7.ローカルLLMにおすすめのBTOパソコン
7-1.Lepton Hydro WSZ890
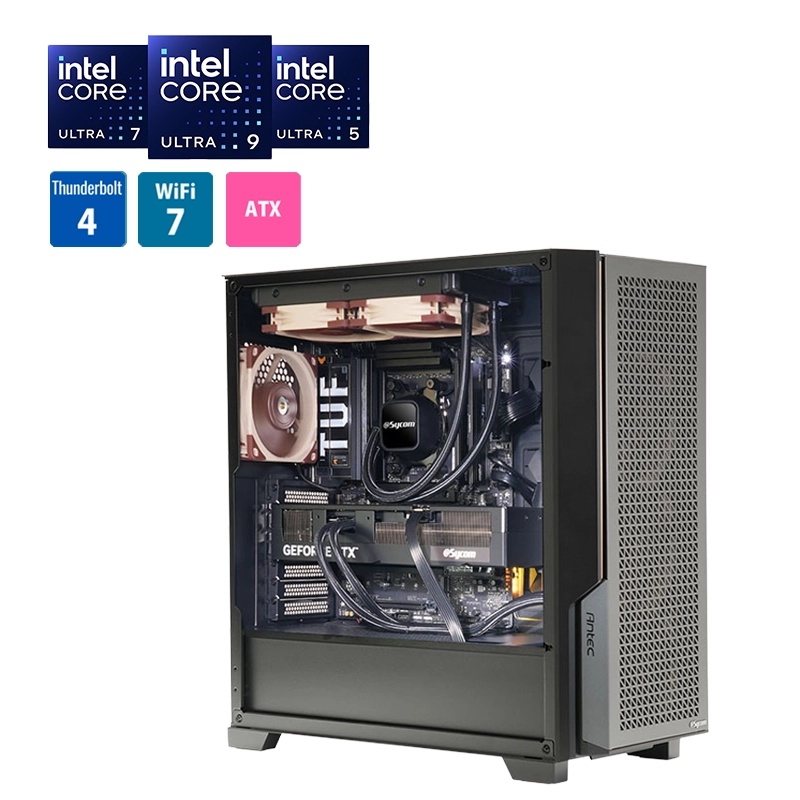
「Lepton Hydro WSZ890」は、BTOメーカー・サイコムが展開するクリエイティブPCのハイエンドモデルです。
CPUとGPUを独立した2基の水冷ユニットで冷却する「デュアル水冷システム」を採用しています。高い冷却性能によって長時間の安定したパフォーマンスが期待でき、AI処理やデジタルクリエイションなど、負荷が大きい作業が続く用途にも向いています。
標準構成では、「Intel Core Ultra 7 270K Plus」と「NVIDIA GeForce RTX 5080」の組み合わせを採用。メインメモリも32GB(16GB×2)となっており、ローカルLLMの運用を検討している方にも適した構成です。より大型のAIモデルを利用したい場合は、メインメモリの増量やストレージの大容量化なども検討するとよいでしょう。
Lepton Hydro WSZ890
| 【Lepton Hydro WSZ890】標準構成 | |
|---|---|
| CPU | Intel Core Ultra 7 270K Plus (3.7GHz/24コア/24スレッド) |
| メモリ | DDR5-5600 32GB(16GB×2) |
| マザーボード | Intel Z890 チップセット |
| SSD | 1TB(NVMe/M.2 SSD) |
| ビデオカード | サイコムオリジナル Hydro LC Graphics® GeForce RTX5080 |
| 外形寸法 | 幅220×奥行き469×高さ490mm |
7-2.Lepton WS3600X870A Twin GPU Edition
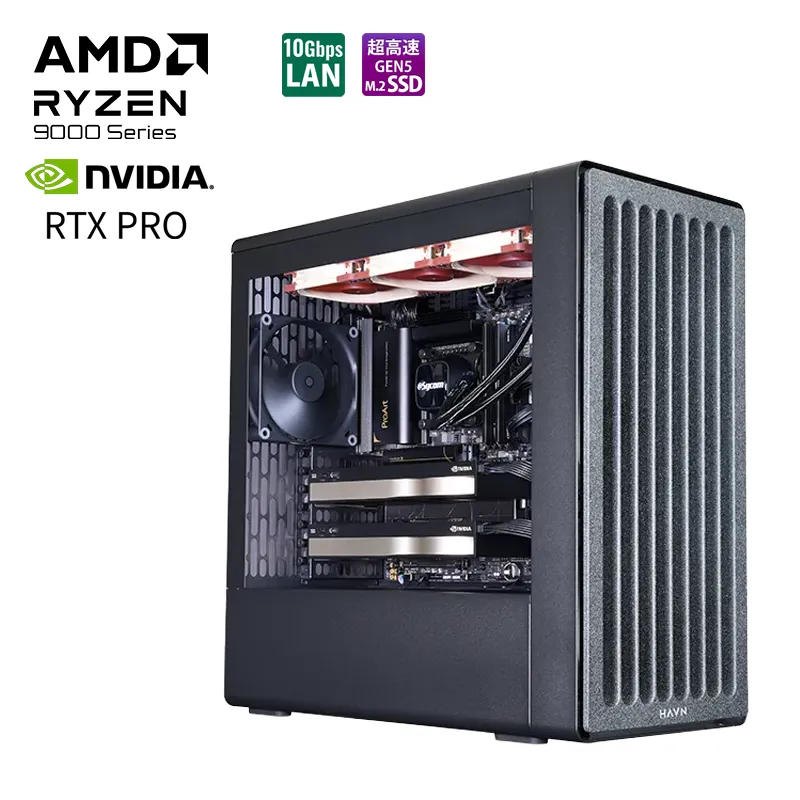
「Lepton WS3600X870A Twin GPU Edition」は、「Twin GPU Edition」の名前が示す通り、2基のGPU(ビデオカード)を搭載したハイエンドワークステーション。AIやLLM開発、RAG、ディープラーニング、画像生成、データサイエンスなど、高い並列演算性能が求められる用途に適した構成で、CPUは16コア/32スレッドの「AMD Ryzen 9 9950X」が標準採用されています。
ビデオカードはプロフェショナル向けの「NVIDIA RTX PRO 4500 Blackwell Workstation Edition」2基を標準搭載。2基のGPUを活用することで、複数GPUに対応したソフトウェアでは、処理を分散することによる性能向上や、より大規模なモデルへの対応が期待できます。メインメモリは標準で64GB(32GB×2)搭載。CPUの冷却には水冷ユニットを採用することで、高い冷却性能と静音性を確保し、長時間にわたる稼働にも配慮しています。本格的なAI開発を目指す方はぜひ注目してみてください。
Lepton WS3600X870A Twin GPU Edition
| 【Lepton WS3600X870A Twin GPU Edition】標準構成 | |
|---|---|
| CPU | AMD Ryzen 9 9950X(4.3GHz/16コア/32スレッド) |
| メモリ | DDR5-5600 64GB(32GB×2) |
| マザーボード | ASRock X870 Taichi Creator |
| SSD | 2TB(M.2 PCI-E Gen5) |
| ビデオカード | NVIDIA RTX PRO™ 4500 Blackwell(32GB)×2 |
| 外形寸法 | 幅254×奥行き515×高さ522mm |
7-3.Lepton Hydro Extreme WSX870A
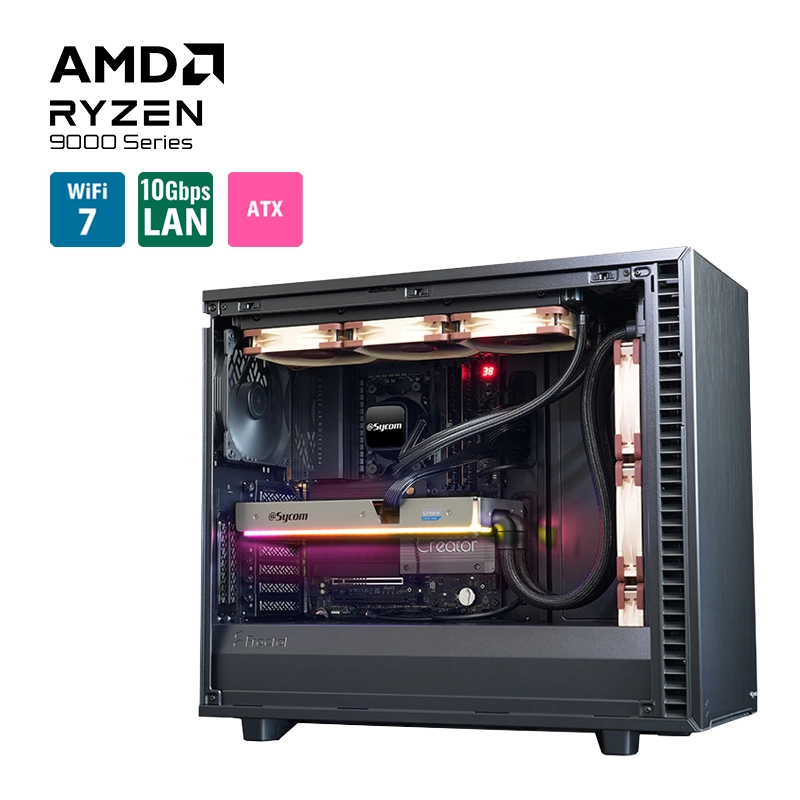
「Lepton Hydro Extreme WSX870A」は、サイコムが独自に水冷化した「NVIDIA GeForce RTX 5090」と「AMD Ryzen 9000」シリーズを組み合わせたウルトラハイエンドワークステーションです。
高いパフォーマンスと安定した動作が期待でき、ローカルLLMで大型モデルの運用したい場合にも適しています。
ビデオカードの「Hydro LC Graphics Plus GeForce RTX 5090 32GB」は、ドイツの冷却メーカー「Lynk+」との協業で実現したサイコムオリジナル水冷仕様モデルです。本格水冷に用いられる銅プレートでPCB全体を覆う機構と、大型の360mmラジエーターを採用しています。32GBのVRAMに加え、メインメモリも標準で64GB(32GB×2)を備えており、ローカルLLMの本格的な運用をするうえでも魅力的な構成です。
Lepton Hydro Extreme WSX870A
| 【Lepton Hydro Extreme WSX870A】標準構成 | |
|---|---|
| CPU | AMD Ryzen 9 9950X3D(4.3GHz/16コア/32スレッド) |
| メモリ | DDR5-5600 64GB(32GB×2) |
| マザーボード | ASRock X870 Taichi Creator |
| SSD | 2TB(NVMe/M.2 SSD) |
| ビデオカード | サイコム オリジナル Hydro LC Graphics® Plus GeForce RTX5090 32GB |
| 外形寸法 | 幅240×奥行き547×高さ475mm |
※製品構成は2026年9月時点の情報です。BTOパソコンの標準構成や選択可能なパーツは変更される場合があります。
8.まとめ
かつてのローカルLLM環境は、導入のハードルが高いものでした。 しかし現在では、高性能なパソコンがあれば運用でき、企業はもちろん、個人でも導入しやすくなっています。軽量モデルであれば比較的控えめなスペックでも試せます。ただし、本格的な運用を目指すなら、VRAM容量の大きいビデオカードを搭載した高性能なパソコンが有利です。
ローカルLLM環境を構築する大きなメリットは、外部のAIサービスへデータを送信せず、自身の環境内でAI処理を完結できる構成を作れることです。個人情報や機密性の高い社内文書などをAIで扱いたい場合でも、適切にネットワークやアクセス権限を設計すれば、情報を外部AIサービスへ送信する構成と比べて、情報管理の範囲を自社側でコントロールしやすくなります。
一方、コスト面でもローカル推論自体には外部APIの従量課金は発生しません。ただし、パソコンの導入費用などの初期コストに加え、電気代や運用・保守費用などのランニングコストも発生する点には注意しましょう。
本記事では、ローカルLLMの仕組みから、運用するために必要なAIモデルやソフトウェア、さらにはパソコンに求められるスペックなどを解説しました。ローカルLLMの導入を検討されている方は、ぜひ参考にしてみてください。
父親の影響で、中学生からパソコンの自作を始める。秋葉原のPCショップでアルバイトをしながら学生生活を過ごし、現在は通信会社の子会社でシステムエンジニアとして勤務。週末は副業でPCやデジタルガジェット系のライターをしながら、今もアキバ通いを続けてます。BTOパソコンは奥が深いです、単に道具として使うだけではなくパーツ選びも楽しみましょう!
BTOパソコン売れ筋ランキング
(9月1日~9月30日)
-

- 1位G-Master Spear 2 X870A
- Zen5アーキテクチャ採用のAMD Ryzen 9000シリーズを搭載するミドルタワー型ゲーミングPC。高性能と高拡張性を実現したゲーマー向けハイエンドモデルです。
-

- 2位Radiant GZ3600X870A
- Zen5アーキテクチャ採用のAMD Ryzen 9000シリーズ搭載ATXミドルタワー型モデル。BTOならではのカスタマイズの幅が広いスタンダードなモデルです。
-

- 3位G-Master Velox II AMD Edition
- コスパ重視のゲーミングPCならコレ!メーカー・型番も明記された安心のオプションパーツからカスタマイズができる、BTOパソコンが初めての方にもオススメな高品質ゲーミングPCです。
-
- 4位G-Master Spear 2 Z890i
- AI時代の新CPU、Intel Core Ultraプロセッサを搭載するミドルタワー型ゲーミングPC。高性能と高拡張性を実現したゲーマー向けハイエンドモデルです。
-
- 5位G-Master Velox III AMD Edition
- 高品質なパーツを採用した納得の標準構成と厳選されたオプションパーツでシンプルなカスタマイズが楽しめる新機軸のゲーミングPC!AMD Ryzen 9000シリーズ搭載モデルです。
-
- 6位Premium Line X870FD-A
- 「いいものを永く」のコンセプトで標準2年保証、無償オーバーホールなど末永くご愛用いただくためのアフターサービスが充実した、AMD Ryzen 9000シリーズ搭載のプレミアムPC。
-
- 7位G-Master Velox Campio Edition 2026
- EAA!!主催「ゲーマー国勢調査」W受賞記念の200台限定モデル。AMD RyzenプロセッサとRADEONシリーズを搭載するハイパフォーマンスなPCにキーボード、マウス、マウスパッドをセット。さらに3年保証が付いたお買い得モデルです。
-
- 8位Silent-Master NEO B850A
- こだわりのNoctua製空冷CPUクーラーを採用し、エアーフローと静音性のバランスを極めた静音PC。AMD Ryzen 9000シリーズを搭載するATXミドルタワー型モデル。
-
- 9位G-Master Velox Mini 2 B850A
- ゲーミングPCはもっと小さくても良い。縦置きも可能な容量21.3リットル筐体にAMD RyzenプロセッサとGeForceシリーズを搭載するコンパクト&パワフルなゲーミングPC。
-
- 10位G-Master Hydro Extreme X870A
- BTO初、サイコム独自に水冷化したGeForce RTX5090搭載!Zen5アーキテクチャ採用のAMD Ryzen 9000シリーズとの組み合わせで、最高のパフォーマンスながら冷却性能と静音性のバランスを高次元で両立したデュアル水冷ゲーミングPC。